资讯
你的位置:开云·kaiyun(中国)官方网站 登录入口 > 资讯 > 欧洲杯体育东谈主们对AI的需求是复兴问题-开云·kaiyun(中国)官方网站 登录入口
欧洲杯体育东谈主们对AI的需求是复兴问题-开云·kaiyun(中国)官方网站 登录入口
发布日期:2026-09-23 09:17 点击次数:74
 欧洲杯体育
智东西
作家 | 王涵
裁剪 | 漠影
2026年,Agent的火爆进程空前。
9月21日,在AICC 2026大会上,IDC发布了一组数字:2026年内行活跃Agent约7940万个,到2030年将达22.16亿个。
而同期Token骤然量的增长更为惊东谈主:从2026年的0.026Peta(千万亿),增长到2030年的152667Peta。Agent数目增长约28倍,Token骤然却增长数百万倍。
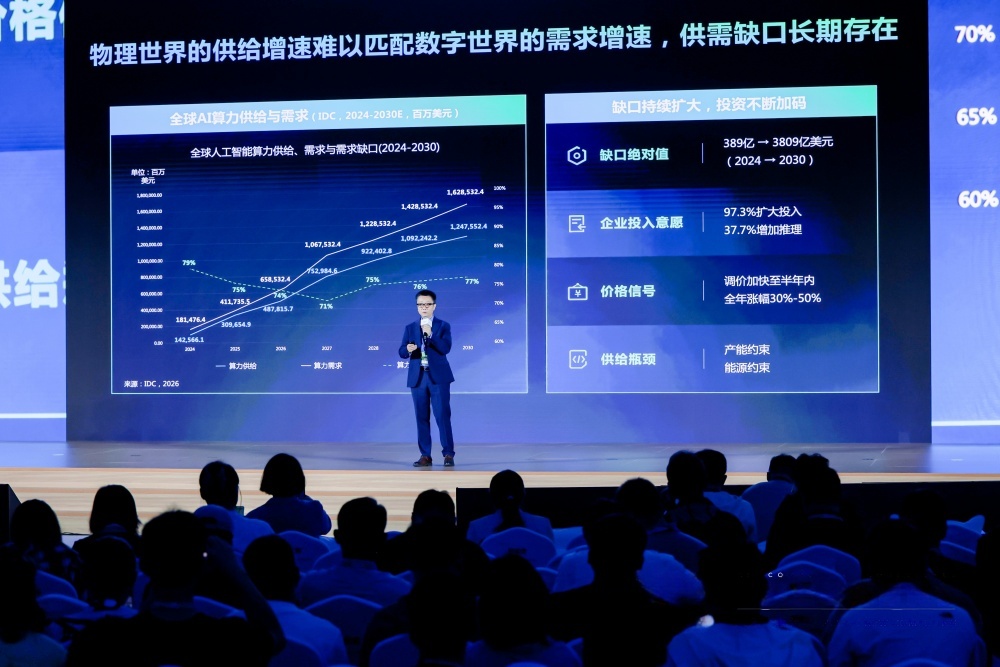
需求侧增长如斯之快,算力供给能接住吗?
本年有两个案例终点典型:
一是Kimi K3。这个总参数目2.8万亿的模子,权重文献达到1.56TB,普通AI服务器的GPU显存连权重都装不下,官方保举至少64卡甚而更大规模才能运行。
它指向的是“朝上”的逆境:当Agent需要更强推理、更长高下文和更多智能体协同,智力上限越高,部署门槛越从单机走向集群。
二是DeepSeek。2026年上半年,它曾将V4-Pro的API价钱下调75%,并称退换遥远有用;但8月又预报合座提价,情理直指“算力不及”。
它指向的是“向广”的逆境:当Agent大规模调用低廉模子,性价比算力的需求被速即放大,容量不够,廉价供给就难以捏续。
这两个问题如何破?
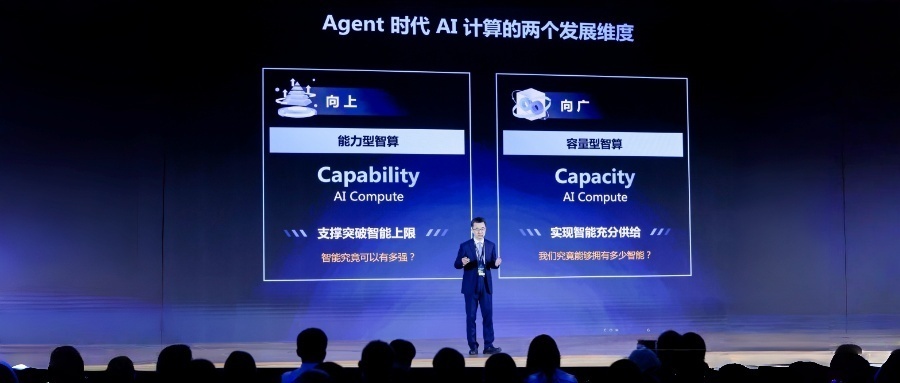
在AICC 2026大会上,波澜信息给出了我方的复兴:朝上,Capability AI Compute;向广,Capacity AI Compute。
会上,波澜信息矜重发布元脑SD200 Ultra超节点AI服务器和元脑HC2000多元算力机组。“朝上向广”两个标的皆头并进,通过系统协同,波澜信息从提供算力走向分娩智能。
一、朝上,超节点冲破智能上限
要通顺朝上的瓶颈从何而来,咱们要先看清AI的需求端发生了什么变化。
往时,东谈主们对AI的需求是复兴问题,算力调用是单次且临时的。而在Agent时期,一次用户意图背后,可能是几十次、几百次甚而更屡次推理,是多个Agent连气儿几小时甚而几天的协同服务。应用形状的变化,径直提高了对算力系统的条件。
与此同期,前沿模子的Scaling up也在这一时期插足加快期。
以Kimi K3为例,其参数目如故达到2.8万亿,权重文献约1.56TB,普通服务器显存连权重都装不下,更毋庸说百万Token高下文。官方保举膨大到64卡甚而更大规模,才能让模子信得过运行。更毋庸说畴昔可能会膨大到十万亿参数目级的愈加前沿的模子。
现如今,芯片之间需要高效通讯,内存需要结伙寻址,数据搬运需要尽可能减少。浅陋地把更多服务器堆在整个,行欠亨了。
超节点的意旨,就在于冲破传统单机的筹备规模,把更多芯片和内存纳入一个高效协同的筹备域,为前沿智能提供更大的“有用筹备空间”。
波澜信息发布的元脑SD200 Ultra超节点AI服务器,恰是围绕这一策画联想。
元脑SD200 Ultra以怒放系统联想紧耦合128芯原土AI芯片,终了结伙内存寻址超低延伸通讯,并以对称直连、算子优化等变嫌时刻减少模子运行中的数据搬移与恭候。
基于这套系统,SD200 Ultra不错单机运行2.8万亿参数的Kimi K3,Token生成时延初度冲破5.85毫秒。
同期跟着模子参数规模束缚晋升,还支捏10万亿参数规模的前沿模子,为模子规模和高下文长度的捏续膨大提供扶植。
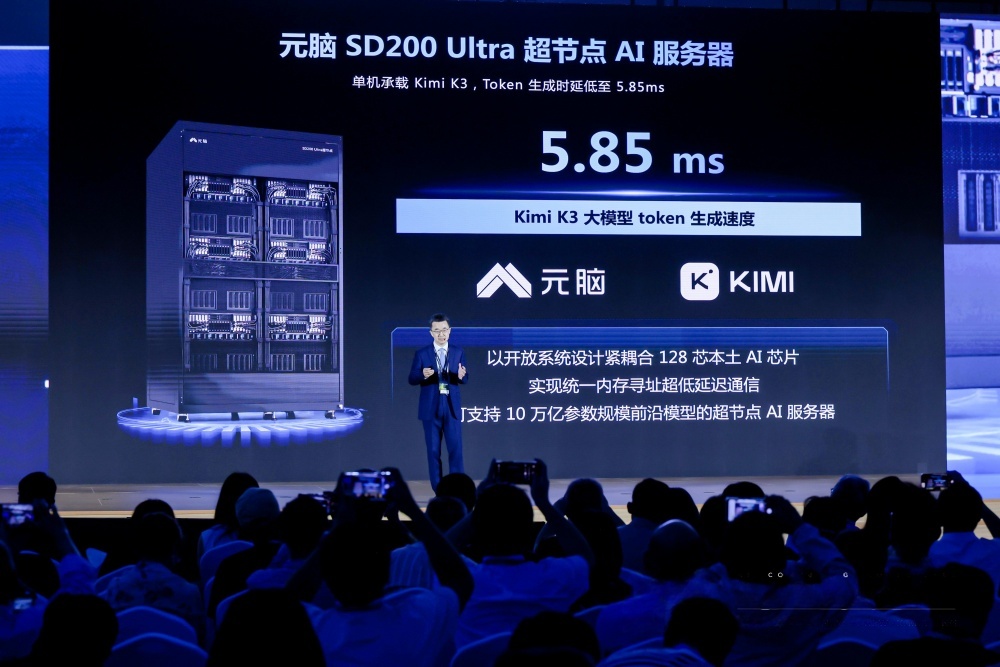
从时刻终了看,SD200 Ultra基于128芯原土AI芯片,摄取3D HyperMesh架构,提供8TB带宽和64TB内存,让前沿模子大略充分应用多颗芯片的筹备与存储资源。
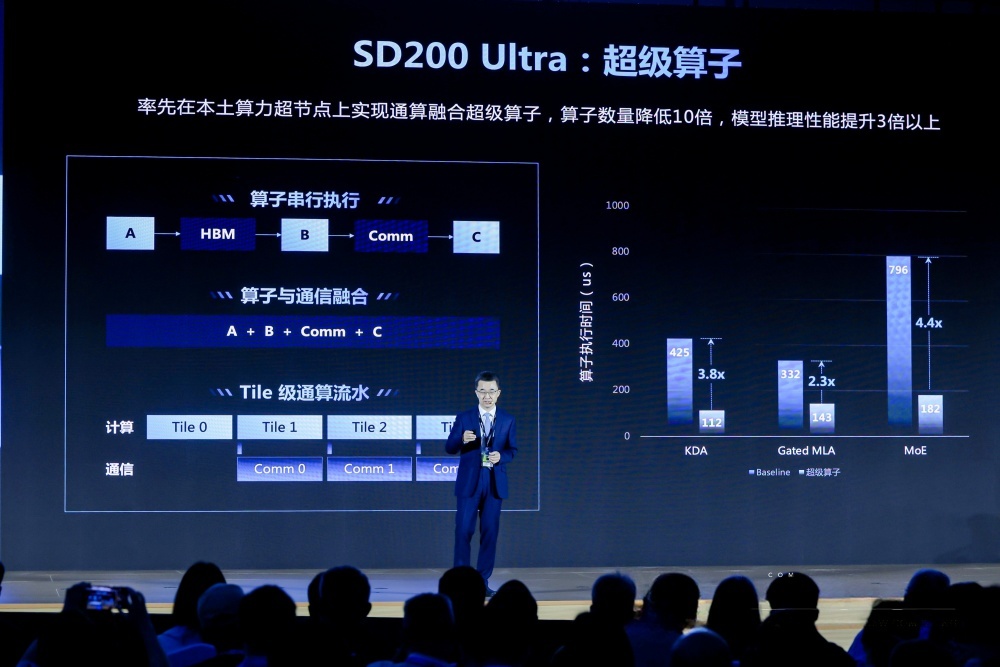
通讯方面,原生内存语义通讯把跨芯片通讯时延质问到0.69微秒;在推理优化上,波澜信息构建超等算子库体系,将KDA、Gated MLA、MoE中的远大基础算子交融为筹备+通讯的大算子,算子数目质问为原先的1/11,大幅减少了Kernel Launch次数,HBM拜谒支出,并袒护了通讯延伸,晋升GPU合座施行后果。
今天,AI如故大略照应困扰学术界几十年的NS方程。智力型智算要作念的,即是让这些前沿智力不仅仅实验室里的演示,而是可落地、可复制的分娩力。
二、向广,让智能供给“供得上、供得低廉”
要是说Capability照应的是“智能不错有多强”,那么Capacity照应的是“咱们究竟大略领有些许智能”。
跟着Agent数目和使用深度加多,Token需求还会链接快速增长。提高单元筹备资源的Token产出,成为规模化供给的要道。
然则,提高Token产出并险阻易。
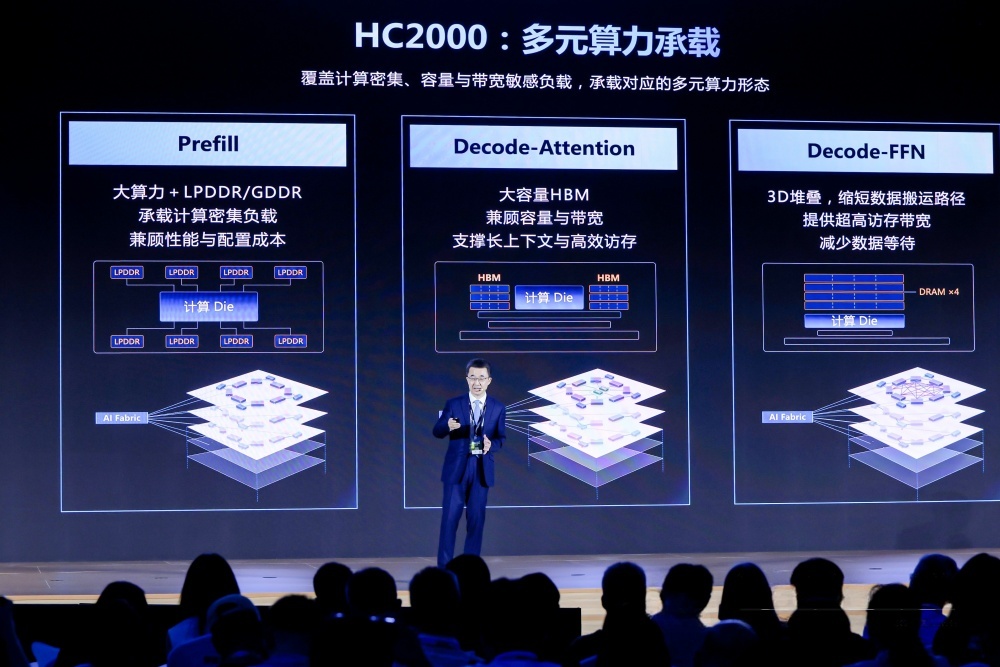
推理不是一种单一筹备模式。Prefill和Decode的筹备特征不同,Attention和MoE对筹备与访存的条件不同。多模态、MTP等模子架构的发展,还会带来更多类型的筹备负载。
浅陋堆更多服务器,不仅不行带来线性智力增长,还可能因为资源虚耗、失衡和任务列队,使部分算力遥远闲置,另一部分资源捏续垂危。
这意味着,容量型智算需要换一种念念路:让不同的算力承担最适合我方的负载,再通过结伙的软件栈把它们组织起来。
波澜信息的谜底,是元脑HC2000多元算力机组。
它面向捏续、大规模推理需求,基于DirectCom 2.0极速架构,以原生液冷高密整机柜为载体,按负载组织筹备资源,终了多元算力协同。
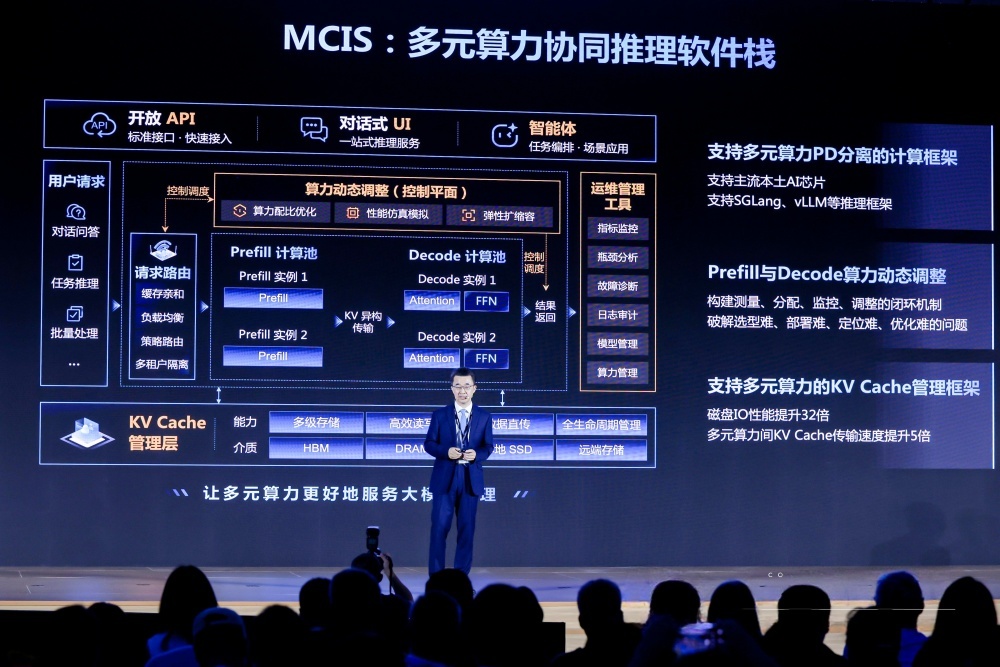
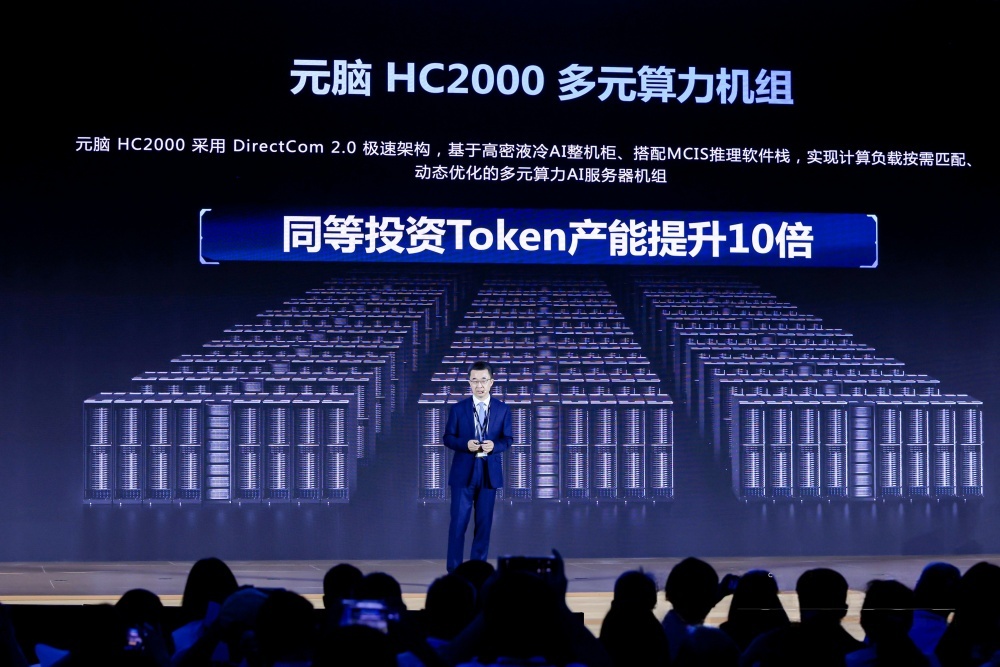
其中枢软件栈MCIS诞生了一套面向多元算力的协同机制:捏续测量不同算力资源的智力与负载,凭据任务需求动态分拨算力,并在运行经由中及时退换资源竖立,让不同类型、不同规模的算力承担更适合的推理任务。
在硬件层面,HC2000摄取全液冷联想和高通流供电,单柜供电智力达到300千瓦以上,最大承载256张AI卡,算力密度终了4倍跃升。
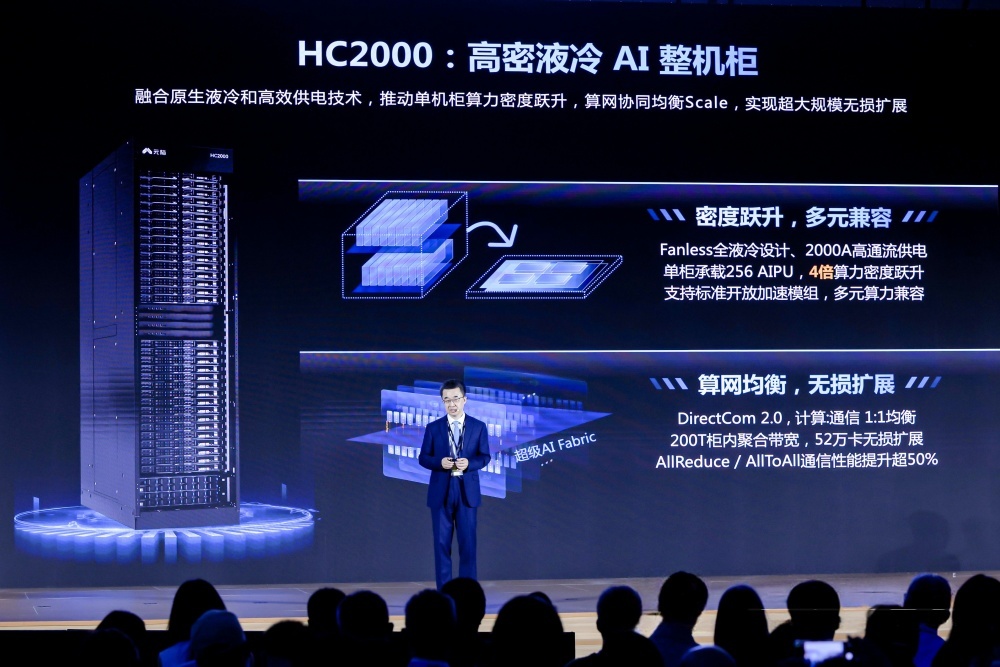
更可贵的是其算力与筹备特征的精确匹配。通过不同组合,多元芯片各司其职,再通过软件栈组织起来,共同完成推理协同,晋升整个算力系统的Token产出后果。
在国产算力基础上,通过MCIS和某模子适配,在典型Agent任务场景中,同等SLO拘谨下,比较单一算力构建的推理系统,终澄澈同等投资10倍Token产能晋升。
波澜信息首席AI策略官刘军曾说:“智能的价值不仅取决于最高点有多高,更取决于有些许东谈主大略获取它。”
向广的逻辑,是要将先进推明智力通过后果晋升和资本下跌,快速走向更平淡的用户,让智能从稀缺资源,迟缓成为整个社会都能获取的基础智力。
三、从Capability到Capacity,为什么需要系统协同?
SD200 Ultra和HC2000,一个朝上,一个向广。看似在作念不同的事情,但它们底层是并吞个判断:当智能运转被“分娩”,算力产业的竞争就不再是单点竞争,而是系统竞争。
刘军将这种念念路综合为“琢磨式变嫌”。
第一个层面,是从芯片、服务器系统到模子的琢磨。
往时作念变嫌,是产业链每一层作念好我方的事——芯片、系统、框架、算法、算子,然后纵向对皆;但在Agent AI时期,面向特定模子需要作念定制化或专用化优化。
第二个层面,是从单机到系统的琢磨。
Capacity需要从前到后的变嫌,把链条上每一武艺拿出来看,凭据不同筹备负载的特征匹配最适合的筹备资源。
Prefill不错用大算力芯片搭配供应和资本更优的LPDDR颗粒;关于Decode阶段,不错采选具有大容量HBM,兼顾显存容量和带宽的AI芯片。
在此基础上,在FFN筹备武艺,不错采选3D DRAM堆叠芯片,进一步缩小数据搬运旅途。破除用并吞种通用巨无霸芯片干整个事的策略,转而构建多元芯片、多元算力系统。
第三个层面,是从时刻到生态的琢磨。
以前通顺“多元算力”,即是服务器厂支捏不同家的AI芯片;但今天出现了新的协同面容:在并吞个业务内部有多元芯片,Prefill用A家芯片,Decode用B家芯片,组成一个算力系统。产业相助从“你赢我输”的零和博弈,转向怒放共赢。
从更长周期看,Capability和Capacity并不是两条平行线,而是一个轮回。
每一次新的智能智力出刻下,时时最初是原意而稀缺的。跟着算法逾越、系统优化和工程熟悉,这些智力会缓缓以更低资本插足更多模子、应用和用户。
Capability负责创造新的可能,Capacity负责让新的可能被更多东谈主获取。
同期,更大规模的智能普及,又会带来新的应用、新的数据、新的需求,股东下一轮Capability冲破。
系统协同,恰是让这个轮回捏续运转的底层机制。
结束:Agent时期,筹备产业从提供算力走向分娩智能
插足Agent时期,Token工场不行只问领有些许GPU、CPU,还应该问:这些算力大略扶植多强的智能?大略以多低的资本分娩些许智能?
波澜信息用SD200 Ultra朝上冲破智能上限,用HC2000向广股东智能规模化供给,一个负责让AI更普遍,一个负责让AI更普及。市欢两者的,是系统级的协同变嫌与怒放生态。
今天的Capability欧洲杯体育,恰是未来Capacity需要规模化供给的智力。Agent时期,筹备产业的责任,也因此变得比以往任何时辰都更宽广。
下一篇:没有了